Claude Opus 5.5 là gì?
Claude Opus 5.5 là mô hình AI mới nhất của Anthropic, ra mắt ngày 22/9/2026 và là mô hình đầu tiên của dòng Claude 5.5. Nó đạt hiệu năng ngang Claude Fable 5.1 ở phần lớn công việc, nhưng chi phí vận hành thấp hơn Opus 5 khoảng 40% và tốc độ sinh chữ nhanh hơn hơn 30%.
Nói ngắn gọn: cùng một khối lượng việc, doanh nghiệp trả ít tiền hơn, chờ ít hơn, và nhận kết quả ở mức của mô hình cao cấp hơn một bậc.
Tóm tắt cốt lõi về Claude Opus 5.5 (Key Takeaways)
Năm ý dưới đây tóm gọn toàn bài.
- Hiệu năng. Ngang Claude Fable 5.1 ở phần lớn công việc, dẫn đầu về lập trình tác tử, sử dụng máy tính và công việc tri thức.
- Chi phí. Rẻ hơn Opus 5 khoảng 40% trên khối lượng việc thông thường. Giá đọc bộ nhớ đệm giảm 60%.
- Tốc độ. Sinh chữ nhanh hơn Opus 5 hơn 30%.
- An toàn. Điểm cao nhất từ trước tới nay trên bộ kiểm tra hành vi tự động của Anthropic, chống prompt injection tốt hơn Opus 5.
- Cách viết. Viết rõ ràng hơn, đưa thông tin quan trọng lên đầu, ít biệt ngữ hơn.
Vì sao đây là một bản phát hành đáng chú ý?
Có ba lý do khiến bản phát hành này khác các lần nâng cấp thông thường.
- Đây là bản đầu tiên sau lời kêu gọi "điều tiết tốc độ phát triển". Anthropic đã công khai kêu gọi làm chậm nhịp phát triển AI để công tác an toàn theo kịp năng lực mô hình. Claude Opus 5.5 là mô hình đầu tiên ra mắt sau tuyên bố đó.
- Được đánh giá độc lập trước khi phát hành. Các tổ chức bên ngoài như METR và Frontier Design đã kiểm tra mô hình trước khi Anthropic công bố.
- Giảm giá thay vì tăng giá. Mô hình mạnh hơn nhưng lại rẻ hơn, đi ngược thói quen quen thuộc của thị trường là bản cao cấp đi kèm giá cao hơn.
Claude Opus 5.5 mạnh tới đâu so với các mô hình khác?
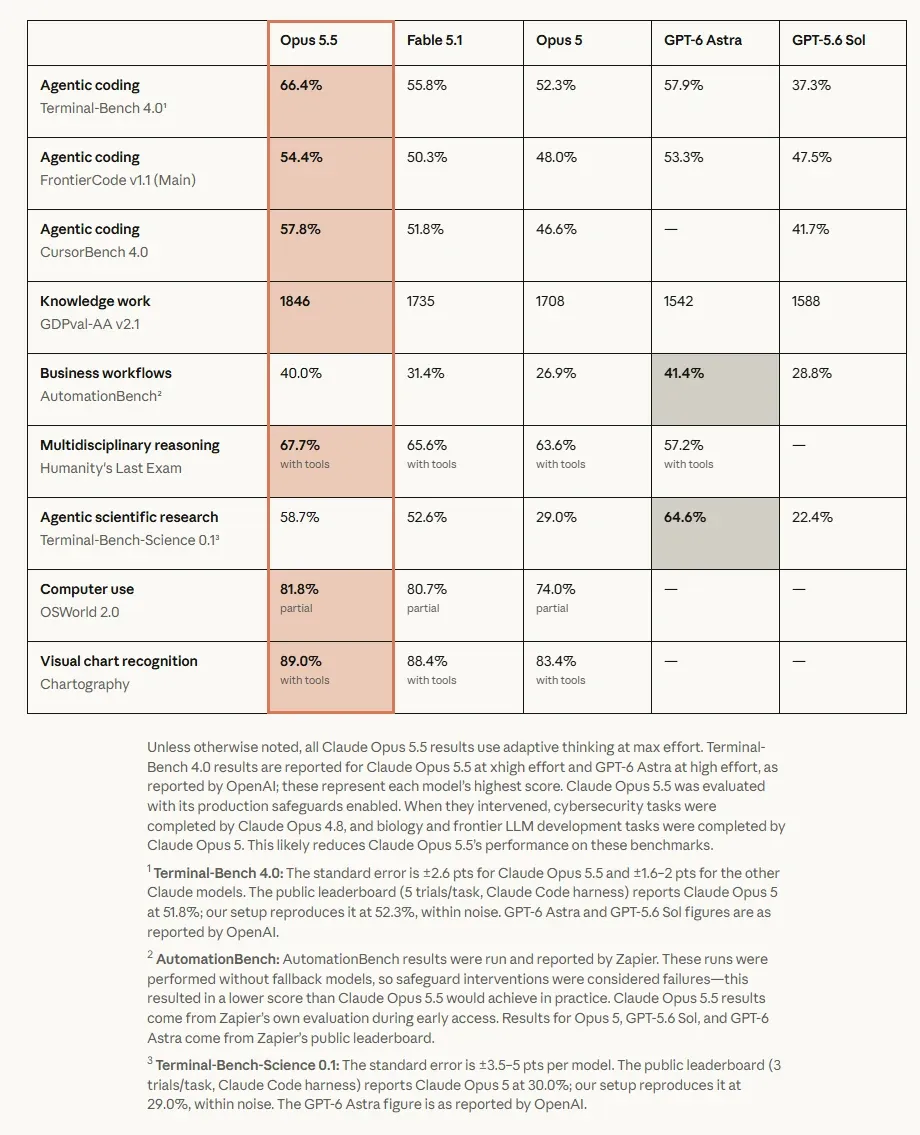
Theo bảng điểm do Anthropic công bố, Claude Opus 5.5 dẫn đầu ở 7 trên 9 bài kiểm tra, nhưng không thắng tất cả.
| Bài kiểm tra | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|
| Lập trình tác tử (Terminal-Bench 4.0) | 66,4% | 55,8% | 52,3% | 57,9% |
| Lập trình tác tử (FrontierCode v1.1) | 54,4% | 50,3% | 48,0% | 53,3% |
| Lập trình tác tử (CursorBench 4.0) | 57,8% | 51,8% | 46,6% | chưa có |
| Công việc tri thức (GDPval-AA v2.1) | 1846 | 1735 | 1708 | 1542 |
| Quy trình kinh doanh (AutomationBench) | 40,0% | 31,4% | 26,9% | 41,4% |
| Suy luận đa ngành (Humanity's Last Exam) | |
Hai điểm cần đọc cho đúng:
- GPT-6 Astra vẫn nhỉnh hơn ở hai hạng mục: quy trình kinh doanh (41,4% so với 40,0%) và nghiên cứu khoa học tác tử (64,6% so với 58,7%).
- Chính Anthropic cũng dặn đừng tin tuyệt đối vào khoảng cách điểm số. Ở mức năng lực này, chênh lệch benchmark không còn phản ánh chính xác khác biệt ngoài thực tế. Trong sử dụng nội bộ, khoảng cách giữa Opus 5.5 và Fable 5.1 hẹp hơn những gì bảng điểm cho thấy.
Nếu bạn đang cân nhắc giữa các mô hình, hãy đọc thêm bài Google Trends AI 3 tháng qua, nơi cho thấy người dùng đang tìm kiếm "claude opus 5" và "claude fable" tăng mạnh.
Giá Claude Opus 5.5 rẻ hơn Opus 5 bao nhiêu?
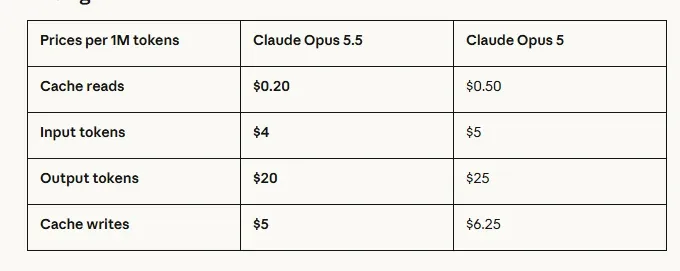
Đây là điểm thay đổi rõ ràng nhất. Mô hình vừa rẻ hơn trên mỗi token, vừa dùng ít token hơn cho mỗi tác vụ, nên tổng chi phí giảm khoảng 40%.
| Giá trên 1 triệu token | Claude Opus 5.5 | Claude Opus 5 | Mức giảm |
|---|
| Đọc bộ nhớ đệm (cache reads) | 0,20 USD | 0,50 USD | 60% |
| Token đầu vào | 4 USD | 5 USD | 20% |
| Token đầu ra | 20 USD | 25 USD | 20% |
| Ghi bộ nhớ đệm (cache writes) | 5 USD | 6,25 USD | 20% |
Dòng đầu tiên quan trọng hơn vẻ ngoài của nó. Theo Anthropic, đọc bộ nhớ đệm chiếm phần lớn chi phí của các công việc lập trình và tác tử AI. Giảm 60% ở đúng khoản đó là lý do tổng hóa đơn giảm mạnh.
- Chế độ nhanh (fast mode) chạy nhanh gấp tới 2,5 lần, giá 8 USD đầu vào và 40 USD đầu ra cho mỗi triệu token, có trên Claude Code và Claude Platform.
- Tăng giới hạn sử dụng 5 giờ cho các gói Pro, Max, Team và Enterprise tính theo số người dùng.
- Lượt đặt lại giới hạn cho người dùng gói thuê bao, có thể lưu lại và dùng khi nào cần.
Hiệu quả trên từng đồng chi phí thể hiện ra sao?
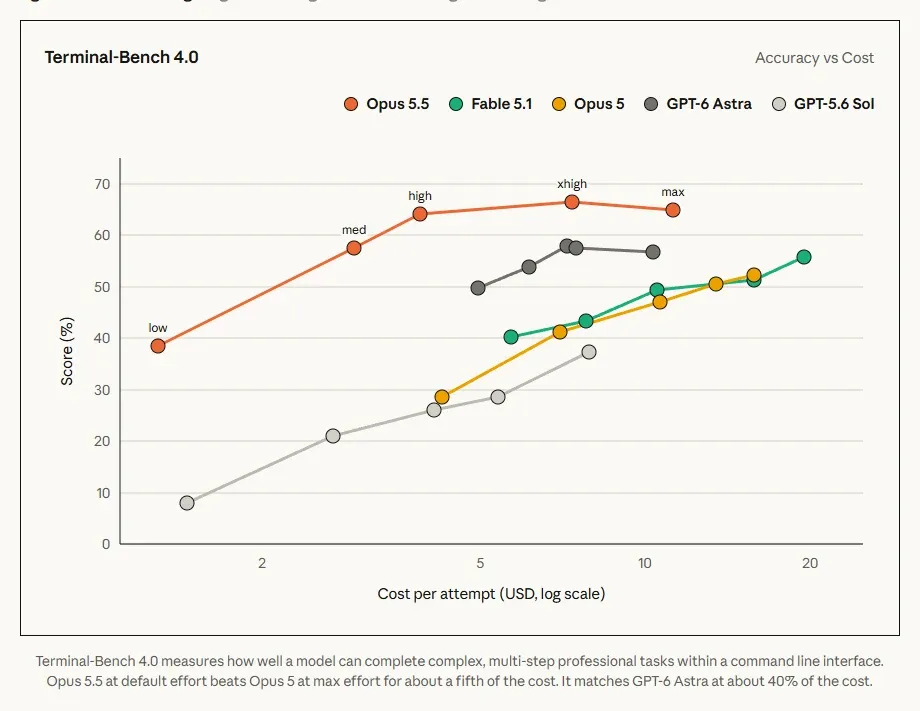
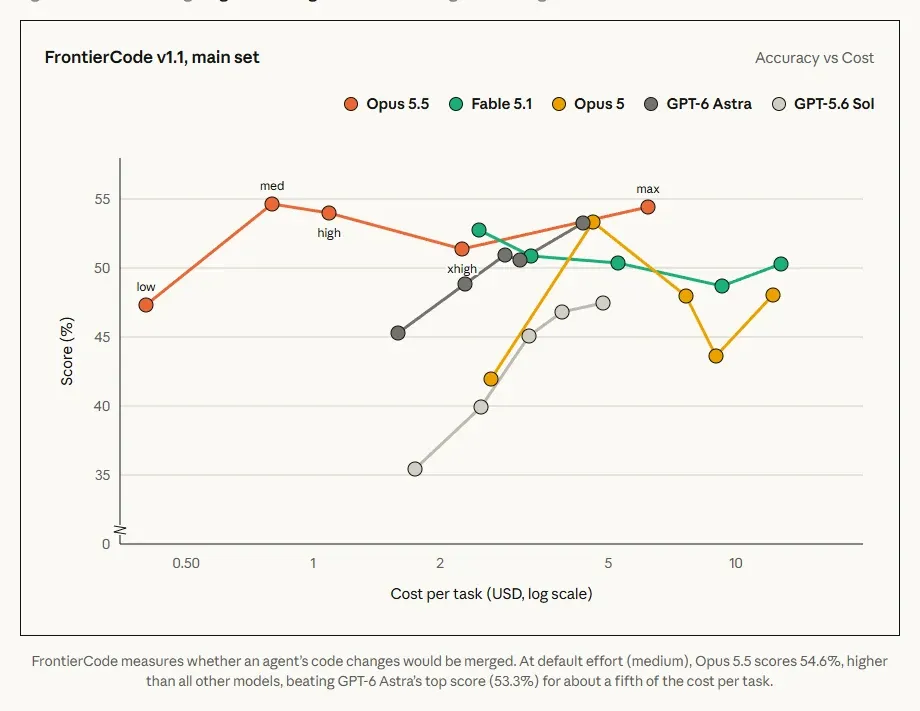
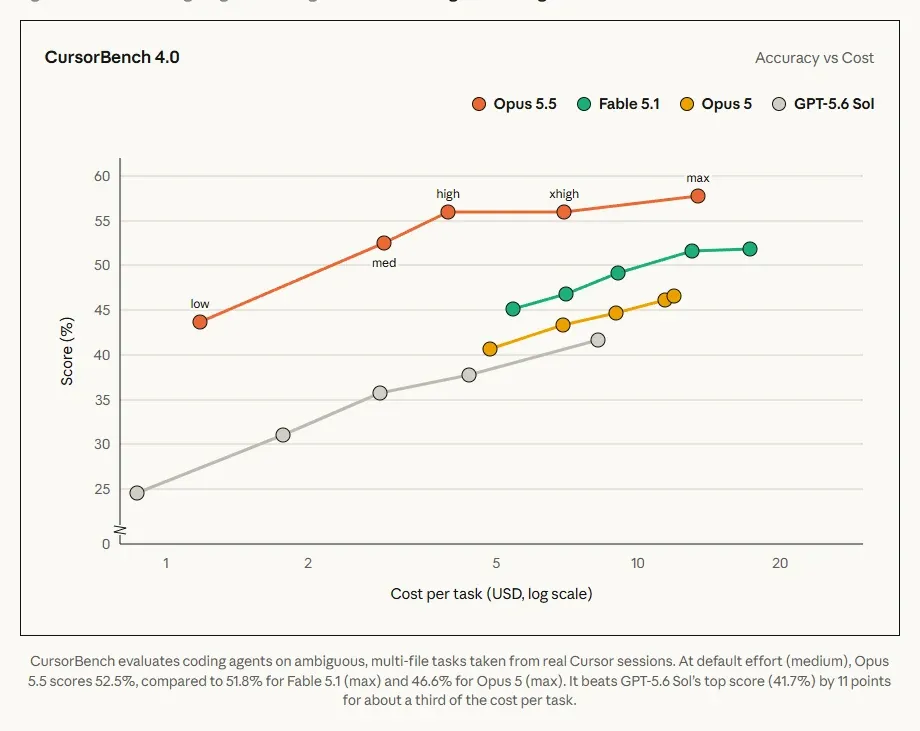
Ba biểu đồ dưới đây đặt điểm số lên trục dọc và chi phí mỗi tác vụ lên trục ngang. Đường càng nằm cao và càng lệch về bên trái thì càng hiệu quả.
Terminal-Bench 4.0 đo khả năng hoàn thành các tác vụ chuyên môn nhiều bước trong giao diện dòng lệnh. Ở mức nỗ lực mặc định, Opus 5.5 vượt Opus 5 ở mức nỗ lực tối đa với chi phí chỉ khoảng một phần năm, và ngang GPT-6 Astra với khoảng 40% chi phí.
FrontierCode đo xem thay đổi mã của tác tử có đủ tốt để được gộp vào dự án hay không. Ở mức nỗ lực mặc định, Opus 5.5 đạt 54,6%, cao hơn mọi mô hình khác, và vượt điểm cao nhất của GPT-6 Astra (53,3%) với chi phí khoảng một phần năm.
CursorBench chấm tác tử lập trình trên các tác vụ mơ hồ, nhiều tệp, lấy từ phiên làm việc thật trên Cursor. Opus 5.5 ở mức mặc định đạt 52,5%, cao hơn Fable 5.1 ở mức tối đa (51,8%), và vượt điểm cao nhất của GPT-5.6 Sol 11 điểm với khoảng một phần ba chi phí.
Điểm chung của cả ba: bạn không cần bật mức suy nghĩ cao nhất để có kết quả tốt nhất. Mức mặc định đã đủ thắng, và rẻ hơn nhiều.
Claude Opus 5.5 lập trình được những việc gì?
Theo Anthropic, mô hình đặc biệt mạnh ở các việc dài và trải rộng như di chuyển toàn bộ mã nguồn hay rà soát cả hệ thống. Các ví dụ được công bố:
- Di chuyển 680.000 dòng mã trong chưa tới một ngày, việc mà một đội kỹ sư thường mất nhiều tuần.
- Rà soát và sửa một kho mã 200.000 dòng trong chưa tới 3 giờ, trong khi Opus 5 mất hơn 20 giờ và tiêu tốn gấp 2,5 lần số token.
- Chuyển phần mềm HAProxy từ ngôn ngữ C sang Rust trong 9,5 giờ, so với 12 giờ của Fable 5.1, với chi phí thấp hơn 51%. Cả hai bản viết lại đều qua gần như toàn bộ bài kiểm thử hồi quy của HAProxy.
- Tối ưu tốc độ tải trang thành công 39 trên 40 lần, trong khi Opus 5 chỉ cải thiện ít hơn và còn làm thay đổi hành vi của ứng dụng.
Phản hồi từ các đơn vị thử nghiệm sớm có một điểm chung: số bước, số lượt gọi công cụ và số token đều giảm mạnh. Một đơn vị cho biết một tác vụ lập trình phức tạp trước đây cần 38 lượt yêu cầu trong bốn ngày, nay chỉ còn 11 lượt trong ba giờ.
Với người không chuyên lập trình, đây là tin tốt nhưng không phải tấm vé miễn trừ trách nhiệm. Những rủi ro khi giao việc lập trình cho AI vẫn còn nguyên, xem bài vibe coding, tại sao bị ghét.
Công việc tri thức và phân tích kinh doanh cải thiện ra sao?
Ngoài lập trình, Claude Opus 5.5 cũng dẫn đầu ở nhóm việc văn phòng và phân tích.
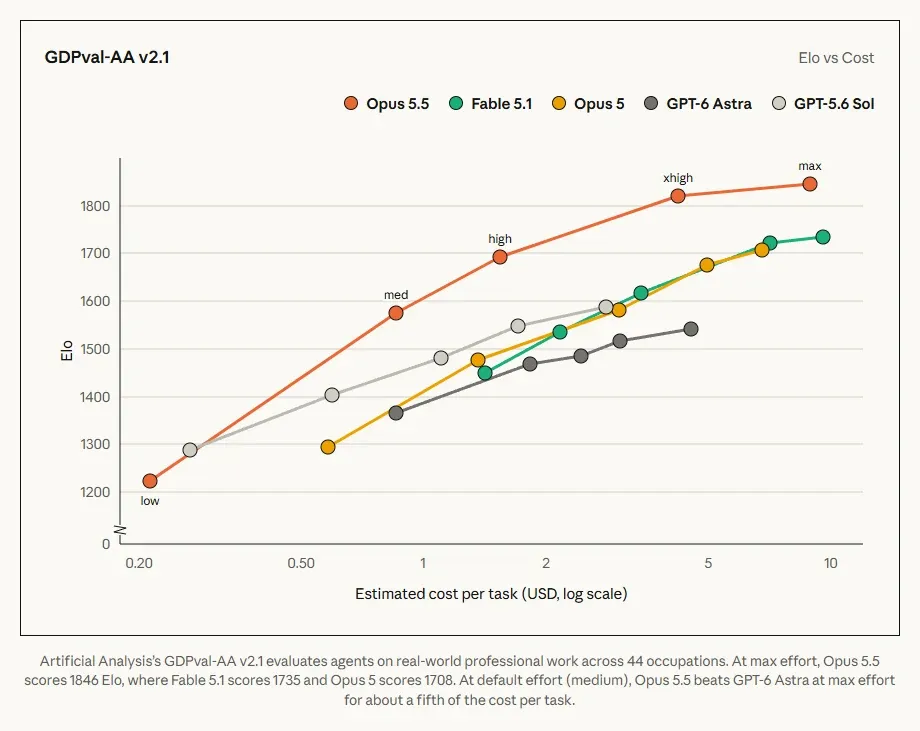
GDPval-AA v2.1 của Artificial Analysis chấm tác tử trên công việc chuyên môn thật thuộc 44 nghề nghiệp. Ở mức tối đa, Opus 5.5 đạt 1846 điểm Elo, trong khi Fable 5.1 đạt 1735 và Opus 5 đạt 1708. Ở mức mặc định, nó vượt GPT-6 Astra ở mức tối đa với khoảng một phần năm chi phí.
Ba thử nghiệm nội bộ đáng chú ý:
- Viết báo cáo mà không bịa số. Mô hình phải viết báo cáo kết quả kinh doanh quý của một công ty, chỉ dùng thông tin tìm được trên một bản sao của web, nơi bản công bố kết quả rất khó tìm. Một công cụ chấm tự động đối chiếu từng con số và trích dẫn với nguồn. Có 16 trên 18 báo cáo của Opus 5.5 đạt chuẩn, trong khi Fable 5.1 và Opus 5 không đạt ở bất kỳ lần nào.
- Phân tích thương vụ sáp nhập. Cả Opus 5.5 và Opus 5 cùng dựng mô hình tài chính trên Excel rồi làm bài thuyết trình. Hai bên cùng đi tới một kết luận, nhưng Opus 5.5 hoàn thành trong 63 phút so với 93 phút, chi phí thấp hơn 50%, và không mắc các lỗi nhỏ như Opus 5.
- Phát hiện lỗi trong chính đề bài. Một quỹ đầu tư thử nghiệm sớm cho biết ở mức nỗ lực cao, mô hình phát hiện một lỗi trong hướng dẫn đánh giá của họ và tự điều chỉnh. Chưa có mô hình nào khác làm được điều này.
Thử nghiệm đầu tiên đáng để doanh nghiệp suy nghĩ nhất. Rủi ro lớn nhất khi dùng AI cho báo cáo là số liệu bịa, và đây là lần đầu có một cải thiện được đo đạc rõ ràng ở đúng điểm đó. Dù vậy, nguyên tắc soát lại vẫn không đổi, như phân tích ở bài lệ thuộc AI khi sếp duyệt kế hoạch.
Cách viết và giao tiếp của Claude Opus 5.5 thay đổi thế nào?
Đây là phần Anthropic nhận nhiều phản hồi nhất về Opus 5, và cũng là phần được sửa nhiều nhất.
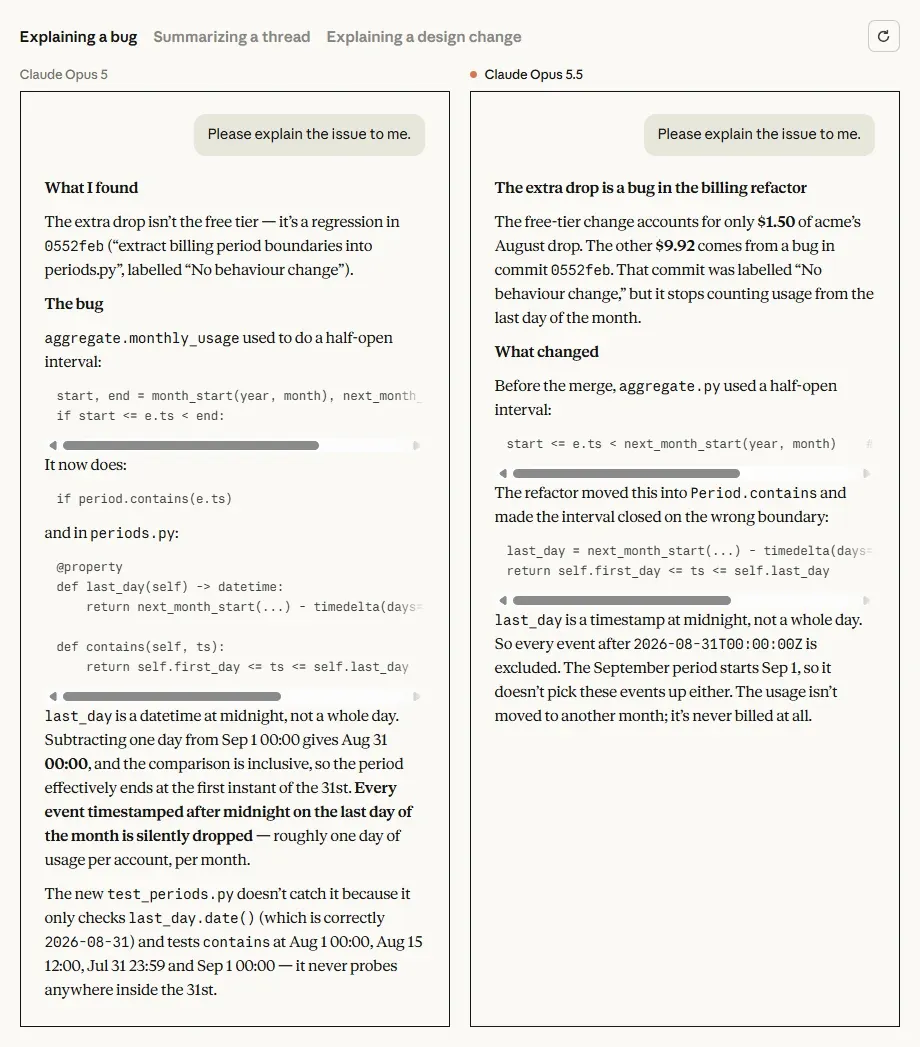
Ví dụ trên là cùng một yêu cầu "hãy giải thích vấn đề cho tôi". Bản của Opus 5 bên trái đi thẳng vào chi tiết kỹ thuật. Bản của Opus 5.5 bên phải mở đầu bằng kết luận và con số tiền cụ thể, rồi mới giải thích nguyên nhân.
- Đưa thông tin quan trọng nhất lên đầu.
- Ít biệt ngữ và cách diễn đạt khó hiểu hơn.
- Tuân theo quy tắc viết mà người dùng đưa ra.
- Dễ theo dõi trong các phiên làm việc dài.
Một người thử nghiệm sớm nhận xét mô hình "viết giống cách tôi viết". Anthropic cũng lưu ý đây không chỉ là chuyện tiện lợi: bài viết dễ đọc thì dễ kiểm tra hơn, và kiểm tra được là một lợi ích về an toàn.
Claude Opus 5.5 an toàn hơn ở những điểm nào?
Anthropic dành một phần lớn bài công bố cho an toàn. Các điểm chính:
- Điểm cao nhất trên bộ kiểm tra hành vi tự động, gồm gần 2.000 tình huống mô phỏng. Mô hình cũng là mô hình trung thực nhất của Anthropic trên phần lớn thước đo.
- Ít vượt ranh giới hơn khoảng 85%. Trong bài kiểm tra mới về xu hướng vượt ra ngoài phạm vi được phép, Opus 5.5 cố vượt ranh giới ít hơn khoảng 85% so với Opus 5 hay Claude Mythos 5.1, và mọi lần thử đều ở mức độ thấp và được mô hình tự báo cáo.
- Chống prompt injection tốt hơn. Mô hình ngang hoặc tốt hơn Opus 5 ở mọi môi trường được thử: lập trình, dùng công cụ, dùng máy tính và duyệt web. Trên bài kiểm tra của công ty bảo mật Gray Swan, nó đồng hạng với Fable 5.1 về tỷ lệ bị tấn công thành công thấp nhất.
- Lớp bảo vệ cho tác tử lập trình. Một bộ phân loại kiểm tra mọi hành động trước khi chạy, một hộp cát mã nguồn mở để đội bảo mật tự kiểm tra, và tính năng rà soát mã bắt lỗ hổng trước khi gộp.
Một giới hạn Anthropic nói thẳng: mô hình thường nghi ngờ rằng nó đang bị đánh giá. Điều này khiến việc dự đoán cách nó hành xử ngoài thực tế trở nên khó hơn. Vì vậy Anthropic kết hợp kiểm tra hành vi với các lớp bảo vệ bổ sung, thay vì chỉ dựa vào điểm số.
Những lớp bảo vệ nào đi kèm?
Vì năng lực về an ninh mạng và sinh học của Opus 5.5 tương đương Claude Mythos 5.1, mô hình được triển khai với các lớp bảo vệ tương tự Fable 5.1:
- An ninh mạng: người dùng vẫn tìm và sửa lỗi trong mã của mình như bình thường, nhưng phần lớn tác vụ an ninh mạng khác sẽ được chuyển sang Claude Opus 4.8. Chuyên gia bảo mật đã xác minh có thể đăng ký chương trình Cyber Verification Program, sắp mở rộng cho Opus 5.5.
- Sinh học: các tổ chức đã được thẩm định như phòng thí nghiệm, công ty khởi nghiệp và công ty dược có thể đăng ký chương trình Life Sciences Verification Program.
- Chống chưng cất mô hình: tính năng giữ nguyên phần suy nghĩ (preserved thinking) ngăn người dùng API chỉnh sửa ngữ cảnh trước đó để trích xuất quá trình suy luận. Áp dụng cho tài khoản API tạo từ ngày 31/8/2026.
- Dữ liệu và tuân thủ: có tùy chọn không lưu dữ liệu, có đóng dấu để tuân thủ Đạo luật AI của Liên minh châu Âu, và không còn cho phép tắt chế độ suy nghĩ.
Nếu doanh nghiệp bạn lo về dữ liệu khi dùng AI, bài training AI là gì giải thích dữ liệu của bạn thực sự đi đâu.
Dùng Claude Opus 5.5 ở đâu?
Claude Opus 5.5 đã có trên mọi nền tảng, bao gồm Amazon Web Services, Google Cloud và Microsoft Azure. Trên Claude Platform, lập trình viên gọi mô hình bằng mã claude-opus-5-5.
Mô hình có mặt trong các sản phẩm của Anthropic như ứng dụng Claude, Claude Code và Claude Cowork. Một số đối tác như GitHub Copilot, Lovable và Kiro cũng đã thử nghiệm sớm và đang đưa mô hình vào sản phẩm của họ.
Doanh nghiệp nên làm gì với Claude Opus 5.5?
Bốn bước dưới đây áp dụng được ngay trong tuần này.
- Bước 1: Đo lại chi phí trên đúng khối lượng việc của bạn. Con số 40% là trung bình của Anthropic. Hãy chạy thử một tác vụ thật bạn đang làm hằng tuần và so hóa đơn.
- Bước 2: Thử mức nỗ lực mặc định trước khi bật mức cao nhất. Các biểu đồ cho thấy mức mặc định đã đủ thắng ở nhiều bài kiểm tra, với chi phí thấp hơn nhiều lần.
- Bước 3: Giao các việc dài có quy trình rõ ràng. Mô hình mạnh nhất ở các việc trải rộng như rà soát, di chuyển dữ liệu hay viết báo cáo nhiều nguồn. Khung chuẩn bị nằm ở bài xây dựng AI Employee cho doanh nghiệp.
- Bước 4: Giữ người thật ở khâu duyệt. Mô hình bịa số ít hơn, nhưng không phải bằng không. Việc liên quan tới tiền và cam kết với khách vẫn cần người soát.
FAQ về Claude Opus 5.5
Năm câu hỏi dưới đây gặp nhiều nhất.
Claude Opus 5.5 ra mắt khi nào?
Ngày 22/9/2026. Đây là mô hình đầu tiên của dòng Claude 5.5, Sonnet 5.5 và Haiku 5.5 sẽ ra mắt trong vài tuần tới.
Claude Opus 5.5 giá bao nhiêu?
4 USD cho mỗi triệu token đầu vào và 20 USD cho mỗi triệu token đầu ra, rẻ hơn Opus 5 khoảng 20%. Giá đọc bộ nhớ đệm là 0,20 USD, rẻ hơn 60%.
Claude Opus 5.5 có mạnh hơn GPT-6 Astra không?
Ở phần lớn bài kiểm tra Anthropic công bố thì có, nhất là lập trình tác tử và công việc tri thức. Nhưng GPT-6 Astra vẫn nhỉnh hơn ở quy trình kinh doanh và nghiên cứu khoa học tác tử.
Claude Opus 5.5 khác Claude Fable 5.1 thế nào?
Opus 5.5 đạt hiệu năng ngang Fable 5.1 ở phần lớn công việc nhưng chi phí thấp hơn. Trên nhiều bài kiểm tra lập trình, nó còn cho điểm cao hơn.
Dùng Claude Opus 5.5 ở đâu?
Trên ứng dụng Claude, Claude Code, Claude Platform với mã claude-opus-5-5, và trên Amazon Web Services, Google Cloud, Microsoft Azure.
Claude Opus 5.5 cho thấy một hướng đi hiếm gặp: mô hình mạnh hơn nhưng rẻ hơn và nhanh hơn. Với doanh nghiệp, câu hỏi không còn là có nên dùng AI mức cao cấp hay không, mà là việc nào đáng giao và giao ở mức nỗ lực nào. Hãy chọn một tác vụ tốn thời gian nhất tuần này, chạy thử trên Claude Opus 5.5 ở mức mặc định và so lại chi phí.